
Моделюй домен, а не діаграму: як не зламати бойову систему DELTA під час переїзду між датацентрами
Бажаю здоров’я! Мене звати Сергій Загрійчук, я — CTO бойової системи DELTA та майор ЗСУ. В IT працюю понад 20 років, свого часу був у Playtika та Google. У 2023 році знову мобілізувався, а зараз разом із командою розвиваю DELTA.
Пам’ятаю перший день обдумування переїзду бойової системи DELTA між датацентрами. Про увесь цей досвід я вже розповідав на DOU Day у травні 2026 року, але
Тож я ділюся ними тут.
Спершу ми відкрили (насправді сіли і відмалювали по пам’яті) опис системи, а там: SQL, NoSQL, Distributed Queues, купа сервісів, інфраструктура, від якої «пухне голова». Щось літає в near-real-time, щось пишеться синхронно, щось асинхронно, десь інтенсивні записи, десь читання. Під усім цим — мережа, по якій літають петабайти даних.
Чесно? Пробила емоція ...
Бо DELTA обслуговує більше 200 тисяч користувачів, користувачів Сил оборони України, користувачів Сил оборони України, отримує понад 25 мільярдів запитів на місяць і має десятки петабайт даних, он у тих стореджах. І це піднімає відповідальність до дуже й дуже високої планки. Ба більше, військові використовують бойову систему 24/7, і ти не можеш просто так взяти і відключити їх під час активних бойових дій.
Це не просто втрата авторитету чи грошей, це втрата життя...
Беручи все це до уваги, ми поставили пряме питання: «Як це перевезти з однієї локації в іншу?» та ще й з мінімальним впливом на кінцевих користувачів, на людей, які стоять на захисті нашої країни.
Звичайно, ми могли просто взяти і написати чи відмалювати якийсь процес переїзду і сказати: «Ось, це воно! Так і поїдемо!»
Але підхід, який ти відмалював на дошці чи описав у документі, не зовсім відповідає поведінці, яка є в реальності. Ти то вигадав! І це ок, наш весь світ і є чиясь вигадка 😊 І саме ця вигадка — не оркестратор, не стореджі, не якийсь інший інструмент — вирішує, чи переживемо ми переїзд, чи ні.
Це і є твоє абстрактне мислення!
Діаграма != модель
«Entities are a state of mind»
William Kent
Сутності — це стан розуму.
Двоє людей можуть мати абсолютно різне уявлення про те, який вигляд має світ.
Із Кента я виніс два поняття.
- Діаграма — це пасивний носій інформації, бо вона фіксує те, що є.
- Модель же робить інше — вона формує те, що ти бачиш, і робить, потенційно, тебе сліпим до того, що в неї не вписується.
Якщо розум прийняв певну модель, то він буде викривляти твої судження так, аби бачити світ структурованим саме таким чином.
І ми, звичайно ж, не були винятком — моделі, які крутились у наших головах, обмежували бачення. Для того, щоб це не зупинило нас, ми вибрали «індивідуально-груповий підхід».
Спочатку кожен, хто входив у робочу групу, відпрацьовував бачення моделі, потім проходили групові сінки для контекстуалізації цього бачення. І так по колу, доки всі питання, які ми генерили протягом цих мітингів, не знайшли відповідей і ми не дійшли до однієї моделі.
Уважний читач може одразу поставити запитання: «А як менеджити ці мітинги, щоб не зайти у вічний цикл?»
Відповідь доволі проста, і знову не моя 😊, я її взяв із книги Ray Dalio «Principles: Life and Work» — меритократія.
Робоча група складалась із
Я навіть дав назву таким процесам — «психотерапія». 😊
А ось і реальний приклад з мого календаря:

Ми у Центрі Інновацій зараз шукаємо нових експертів для таких «робочих груп». Кількість користувачів DELTA зросла втричі за останній рік, тож ми розширюємо команду: актуальні вакансії зібрали тут.
Що таке «одна група»
«Categorization is not a matter to be taken lightly»
George Lakoff
Для переїзду ми вибрали парадигму груп, але що таке група? Тут я знову повернуся до згаданої книги. Кент ставить питання, яке на перший погляд звучить доволі дивно: «What is one thing?» Що таке одна «штука»?
Його класичний приклад — деталі й склади. В inventory-системі «деталь» означає один вид деталі, у якого можуть бути тисячі фізичних екземплярів. У системі контролю якості та сама «деталь» означає один конкретний фізичний об’єкт, бо кожен проходить свої тести.
І тут поняття категорії стає максимально розмитим. Виходить, що «одна штука» — це не властивість предмета, а функція контексту, в якому ми його рахуємо.
Цікаво!
«Women, Fire, and Dangerous Things». Це ще одна книга, а також реальна категорія з мови дірбал: вона зводить в один клас жінок, вогонь і небезпечні речі. За класичною логікою категорія — це набір спільних необхідних і достатніх ознак. А ця послідовність, на перший погляд, — маячня! Що спільного у жінки з вогнем? Нічого! (Ну, практично нічого :)). Але в самій культурі категорія абсолютно когерентна, бо людські категорії будуються не навколо спільних властивостей об’єктів, а навколо прототипів реального світу і того, що важливо для того, хто категоризує.
Тобто, в контексті австралійських аборигенів це логічні і послідовні «штуки», а в «нашому», принаймні у моєму, не дуже.
Такі важкі філософські реверанси підводили до доволі банальної думки — ми не розбивали сервіси на групи за бізнес-доменами, а за тим контекстом, що був важливий для переїзду, — незалежність і здатність перемкнутися як ціле.
Сервіс потрапляв у групу не тому, що мав якусь спільну «природу» з рештою, а тому, що так розрізати було вигідно для перемикання між датацентрами (далі — ДЦ).
Як приклад, після декількох сеансів «психотерапії» наша модель почала виглядати приблизно ось так:

Модель вирішує, що важливо
«We are not modeling reality, but the way information about reality is processed, by people»
William Kent
Модель кодує те, що важливо, діаграма цього не диктує. Це рішення, рішення реальних людей! Ми визначили, що наші дані можуть мати високу цінність, посередню або низьку. На діаграмі такого виміру немає, а от у моделі він став ключовим.
Він і розблокував один із трюків цього переїзду — паралелізм.
DNS-пропагація має час оновлення — поки оновляться кеші DNS-серверів і почнуть віддаватися нові IP, минають десятки секунд. Наївний погляд — це мертвий час, сидимо й чекаємо.
У будь-якого стореджа, хоч би яка була налаштована реплікаційна політика, є реплікаційний лаг. І якщо політика працює за принципом last-write-wins, то під час перемикання можна втратити те, що залежало від реплікації.
Це дві різні «штуки», на перший погляд не консистентні, але якщо глянути під іншим кутом, розширити/змінити контекст, то все це починає «грати іншими барвами». 😊
Під час сеансів «психотерапії» ми викристалізували ці два аспекти, і тоді рішення стало очевидним — ми групуємо критичні дані, корапшн яких допустити не можна, і даємо їм закінчити реплікацію саме тоді, коли йде DNS-пропагація.
Даунтайм нікуди не зник — але він використаний з користю. А далі перемикаємося група за групою, бо тимчасова відсутність некритичного функціоналу для кінцевого користувача не страшна.
Це і є дивіденд від моделювання. Інсайт був невидимий, поки ми за допомогою цього процесу не розділили дві «штуки» та не знайшли одну категорію для них.
Правильна абстракція для Data Flow
«Software is invisible and unvisualizable»
Fred Brooks
Групи стали моделлю, решта — це проєкція моделі на інфраструктуру. Покажу на двох прикладах, бо тут добре видно, як модель диктує технічні рішення, а не навпаки.
- Канали. Беручи до уваги мережу, ми побудували окремі тунелі між ДЦ під структуровані дані, неструктуровані дані й користувацькі запити — з різною пропускною здатністю і різними підходами. Якщо користувацький трафік мегакритичний, latency мала бути мінімальною. Якщо реплікація якихось неструктурованих даних може йти повільно — latency може бути вищою. І щоб вони не перетиналися між собою, ми зробили private network backbone. Реальність тут одразу «відтестувала» нашу модель. Коли перемикали перші групи, з’явилися петлі трафіку й latency полізла вгору, бо інтенсивна реплікація почала забивати канали. Модель же задекларувала ці потоки не як один, тому канали вижили, і користувачі навіть не знали, що DELTA була «на шпагаті» між двома ДЦ.

- Брокер. Ми розбили exchange’і та черги на віртуальні хости за групами — кожна група мала свій vhost. Це буквально логічні межі моделі, спроєктовані на топологію RabbitMQ. Група А продюсить у чергу на vhost A, івент федерується і консюмиться групою Б з vhost B. Перемикаємо групу А в новий ДЦ так, щоб її користувачі в старому навіть не знали про переїзд; перемикаємо федерацію між vhost A нового ДЦ і vhost B старого автоматичним пайплайном; розриваємо стару реплікацію — і група А вже в новому ДЦ, а група Б ще в старому, і жодна не в курсі, що вони в різних локаціях.

War Story: Технічна лірика
Чому федерація, а не shovel? Спокусливо сказати «бо shovel втрачає дані» — і це була б не зовсім правда, shovel у режимі on-confirm (а це дефолт) видаляє повідомлення із джерела тільки після підтвердження від віртуального хоста, який приймає дані. Реальна різниця більш ювелірна — і саме вона лягла в основу нашої моделі. Shovel пушить агресивно, проштовхує повідомлення приймачу незалежно від того, чи готовий там хтось їх прийняти. А під час перемикання між ДЦ приймач — це якраз он той брокер, що може зараз флапати через нестабільність каналу чи інші інфраструктурні/логічні проблеми. Тобто shovel може створювати ризик саме там, де потенційно буде найгірше. Федеровані черги працюють навпаки, pull-on-demand — повідомлення йдуть до отримувача тільки тоді, коли консюмер готовий їх забрати. Нестабільний ДЦ приймача — і дані просто лишаються на відправнику, поки той бік не відновиться (нічого не пушиться в брокер, який і так ледь дихає). Плюс федерація з коробки не плодить петель на двосторонніх лінках (через x-received-from і max-hops). І тут питання стає не «що краще взагалі», а «що відповідає моделі» — вимозі не кораптити критичні дані по дорозі. (Сама механіка RabbitMQ під навантаженням — quorum queues на Raft, заміна Mnesia, Producer First проти Consumer First — заслуговує окремої статті; тут вона лише як ілюстрація).
Як зрозуміти, що модель хороша
«The complexity of software is an essential property, not an accidental one»
Fred Brooks
Як ви розумієте, ми ітерувались, поки не прийшли до загального контексту. Але чи це відповідь на питання, чи достатньо гарна модель?
Не думаю. Як говорив Дуайт Ейзенхауер: «План — ніщо! Планування — то все!»
Так от, процес планування то і є процес тестування вибраної моделі на відповідність реальності!
Для цієї перевірки я вибрав практику dry-run-ів — підхід, яким американські пожежники, а згодом військові в Другу світову відпрацьовували навички: проганяли всі тонкі місця, щоб у реальному бою все пройшло гладко.
Ми тестували всі кроки перемикання, збір метрик, перевірки — для всіх груп, у визначені дні. Усі тренувалися й виправляли помилки. І dry-run-и знайшли не одну.
АЛЕ,
За весь цикл dry-run-ів архітектура переїзду не змінилася жодного разу.
Баги ми знаходили — десь race condition, десь health check зеленів передчасно, десь скрипт рестартував не те, що треба. Але це все рівень реалізації. Сама модель — групи, паралельна DNS-пропагація з реплікацією — лишилася такою ж, як на першому слайді.
Фредерік Брукс в есе «No Silver Bullet» поділив складність на essential і accidental: essence — це складність, властива самій задачі, accident — складність, яку ми притягли інструментами й реалізацією. Подивимось на наші баги під цим кутом: race condition, передчасно зелений health check, скрипт, що рестартує не те, — це все accident, а модель груп, паралельна пропагація з реплікацією — це essence.
За весь цикл dry-run-ів змінювався тільки accident, а essence залишався без змін. Коли accidental-складність активно змінюється, а essential не рухається — це не випадковість, це ознака, що модель підібрана коректно.
Звідси й критерій. Якщо реальність протягом десятків днів пробувала розламати модель, а та витримала удари без переструктурування — модель доволі стабільна, щоб бути використаною. Якщо ваші dry-run-и постійно змушують переписувати план — проблема не в репетиціях, а в самому плані.
Модель хороша не тоді, коли вона гарна на діаграмі, а тоді, коли реальність не може її зламати, принаймні щодо тих питань, які ви ставите перед нею.
Zero Downtime, Zero Panic — і чесний trade-off
«All models are wrong, but some are useful»
George Box
Завдяки автоматизації пайплайнів, розумінню мережі та паралелізації DNS-пропагації з реплікацією ми були дуже близькі до Zero Downtime. Але дещо вирішили залишити як є і пішли з мінімальним даунтаймом — навіть меншим за заплановані п’ять хвилин. Повністю недоступною DELTA була менше хвилини. Це свідомий trade-off, бо добивати останні відсотки означало б витратити ще більше часу на «боротьбу з вітряками». Ми завчасно попередили користувачів, провели переїзд у час найнижчої активності користування і зробили все, аби переїзд пройшов непомітно. Так і сталося.
Модель — це і про те, де не треба платити більше.
Наша модель груп не була правильною в сенсі «єдино істинної». Інша команда з іншими критеріями провела б інші межі — і вони могли бути не гіршими, просто іншими, і вона теж переїхала б. Або ні — то паралельна історія, і ми її не знаємо. Цінність не в тому, що наш підхід збігся з якоюсь істиною, а в тому, що він витримав реальність і дав десяткам команд один спільний контекст. А наявність одного контексту, як показав цей переїзд, — це вже половина справи.
І наостанок...
Діаграму можна намалювати за день. Але чи вибрана тобою модель, яка лягла в основу діаграми, гарна — ти дізнаєшся тільки тоді, коли реальність заї...ся втомиться її ламати.
Якщо ти дочитав до кінця — нам по дорозі. Ми у DELTA розширюємо команду: можливо, наступний пост про її досягнення напишеш ти. Вакансії тут.
14 коментарів
Додати коментар Підписатись на коментаріВідписатись від коментарівА якщо датацентру «не стало» (навіть не фізично) то розгортання замість переїзду, чи активація дублюючого датацентру, певним компонентам якого лише дається команда стати праймері, щоб з інших цодів парні компоненти інших рівнів самі переключилися на них, бо знають всіх хто в такій дублюючі групі по всім цодам (спілкуються завжди з поточим головним). Такий собі кролик (скоріш їжак з братами, як в сказці в різних місцях, поки вовк бігав) з купою норок. Бігай лови братів по полю. З цим як?
Дякую, гарне питання. Стаття про планову міграцію, а ви описуєте DR-сценарій — коли одного ДЦ фактично більше немає.
Так, на рівні окремих компонентів auto-failover/leader election працює саме так — живі ноди визначають primary, а клієнти йдуть туди.
Але при втраті цілого ДЦ залишаються речі, які самі компоненти не вирішать: RPO, split-brain/fencing, перенаправлення трафіку та правильний порядок перемикання залежних систем. Тому DR — це не лише auto-failover, а ще RPO/RTO і перевірений сценарій відновлення.
Міграція тут дуже допомогла: групи стали природними одиницями перемикання, а dry-run’и — фактично повноцінними DR-вправами.
Конкретну топологію резервування публічно коментувати не буду — думаю, причина очевидна.
Прийшов почитати технічну статтю а натомість бачу як автор пафосно самостверджується своїми глибочайшими знаннями. Ну крутий!
бо автор дійсно крутий)
Молодці!
Дякую!
Забагато якогось цукру філософського, але показово, що за стільки років дельта як була на коліні зліплена так і є. Що значить «з однієї локації на іншу», тобто вона весь цей час була single datacenter? Памʼятаю малюнки 2016(?) де завжди малювалася реплікація та high availability. Якщо б це було реалізовано, то просто вимикаємо непотрібний дата-центр і переїзд відбувається сам собою.
Я от погуглів і виявляється, що МОУ отримало сертифікацію на свої системи по iso27001:2022, mod.gov.ua/...vidnist-standartu-iso-iec
А там має бути працюючий disaster recovery plan, чому тоді СТО так фрустрировав коли вивчав архітектуру свого рішення, коли це все мало бути задокументовано і перевірено у рамках аудіту. Може через це ims і відкликав сертифікат. І це усе за наші гроші, друзі
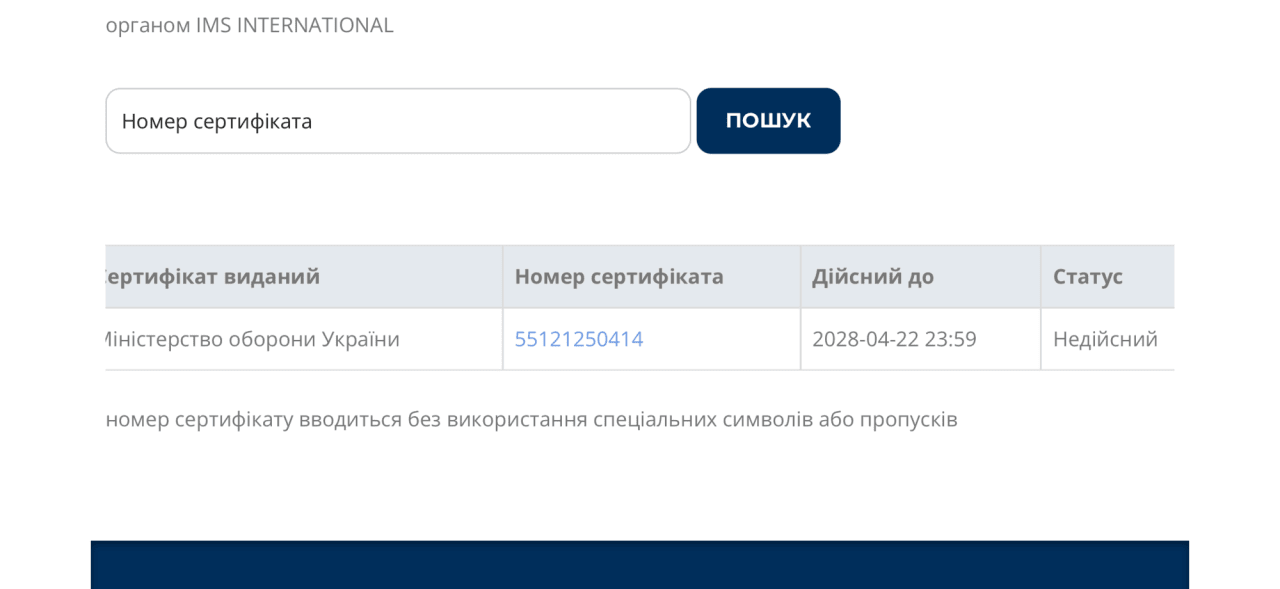
Люблю подібних теоретиків, які не маючи достатньо контексту, а часто й in-field досвіду, розповідають як воно все легко і прекрасно насправді робиться:)
Що може про це знати Qa at wix? Йди потестуй кнопочку, не лізь в незрозуміле
Дякую за коментарі. Коротко по пунктах.
1. «Філософський цукор» — мета статті показати хід думок, а не дати сухий runbook.
2. Це не single DC. У статті описана робота між двома ДЦ: реплікація, окремі канали, поетапне перемикання груп.
3. «Вимкнули ДЦ — і переїхали» — це failover, а не міграція. Failover — перемикання на вже існуючий peer у поточній топології. Міграція — новий сайт, якого в топології ще немає: перенести десятки петабайт, перебудувати реплікацію, переключити primary і трафік без втрати записів.
4. «Фрустрація» була від масштабу відповідальності, а не від незнання архітектури.
5. ISO 27001 сертифікує ISMS, а не конкретну DR-архітектуру. Наявність сертифіката не означає «має бути два ДЦ і можна просто вимкнути один».
6. І «йди потестуй кнопочку» — зайве. Один із найсильніших інженерів, з якими я служив у2015–2016 роках, мав тайтл QA. Ми разом розгрібали протоколи, network stack і зв’язок у полях. Тайтл дуже мало говорить про рівень інженера.
для 2026 якось пізно, але чому ні
читаємо
при повноцінному рішенні таких думок не зʼявляється, тобто до цього переїзду і філософії реплікації дельта була у єдиному дата-центрі. або сформульовано так
ніт, це тепле та мʼяке, файловер має працювати між якимись обʼєктами, маючи повноцінну реплікацію між дата-центрами зникнення одного чи деяких дає механізму фейловера обрати працюючий, але користувач цього не помітить. наскільки можна зрозуміти з статті у фіналі цього таки добилися.
тобто ваш аудитор прийняв систему, у який нема повноцінної availability і була single point of failure, окей, добре що сертифікат відкликали. security у абревіатурі isms це не тільки кібербезпека, а у тому числі і The CIA Triad
потужно. більше б нам таких проєктів
Дякую!