
Claude Opus 5.5: тест рівнів effort від low до max
Привіт! Я з Кореї, роблю ігри з ШІ (пишу українською з допомогою перекладача, вибачте за помилки). Цього разу я прогнав один і той самий промпт на всіх п’яти рівнях effort у Claude Opus 5.5 і все виміряв.
У Claude Opus 5.5 є налаштування effort, яке визначає, наскільки глибоко модель міркує. Рівнів п’ять: low, medium, high, xhigh і max. Вищі рівні мали б давати кращий результат, але офіційна документація не каже, скільки додаткового часу й грошей коштує кожен із них. Тож 9 жовтня 2026 року ми запустили той самий запит на створення гри по одному запуску на кожному рівні й порівняли час, токени, вартість і результат. Найшвидший рівень упорався за 32 секунди, найповільніший — за 22 хвилини. Нижче — що змінювалося на кожному рівні, який рівень обрати для якого завдання, а також особистий досвід використання.
Що таке effort
- Він задає, скільки модель міркує. В Opus 5.5 міркування не можна вимкнути; effort визначає їхню глибину. Токени міркувань оплачуються як вихідні токени.
- За замовчуванням — medium. В Opus 5 за замовчуванням був high; в Opus 5.5 — на рівень нижче, medium (за документацією Anthropic).
- Як змінити: у Claude Code — опція
--effort(від low до max); в API — значенняeffort.
Як ми вимірювали
- Модель: Claude Opus 5.5 у Claude Code на ПК з Windows
- Промпт (дослівно): «Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish.» Тобто: зробити браузерну гру «арканоїд» одним файлом index.html у поточній теці, з 2 рівнями, показом рахунку, 3 життями та керуванням із клавіатури й миші.
- Метод: той самий промпт у п’яти запусках, змінювався лише effort. Кожен рівень працював у власній теці, щоб запуски не впливали один на одного.
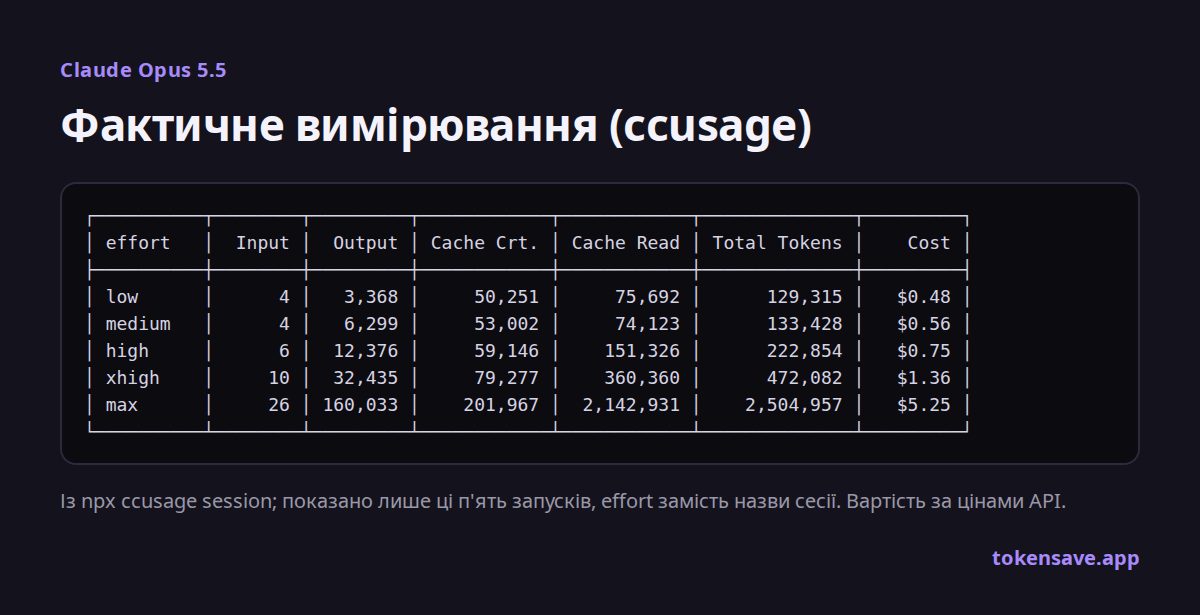
- Вимірювання: токени й вартість — безкоштовним інструментом ccusage, час — за мітками початку й завершення. Вартість перераховано за цінами API.
Результати: час, токени й вартість
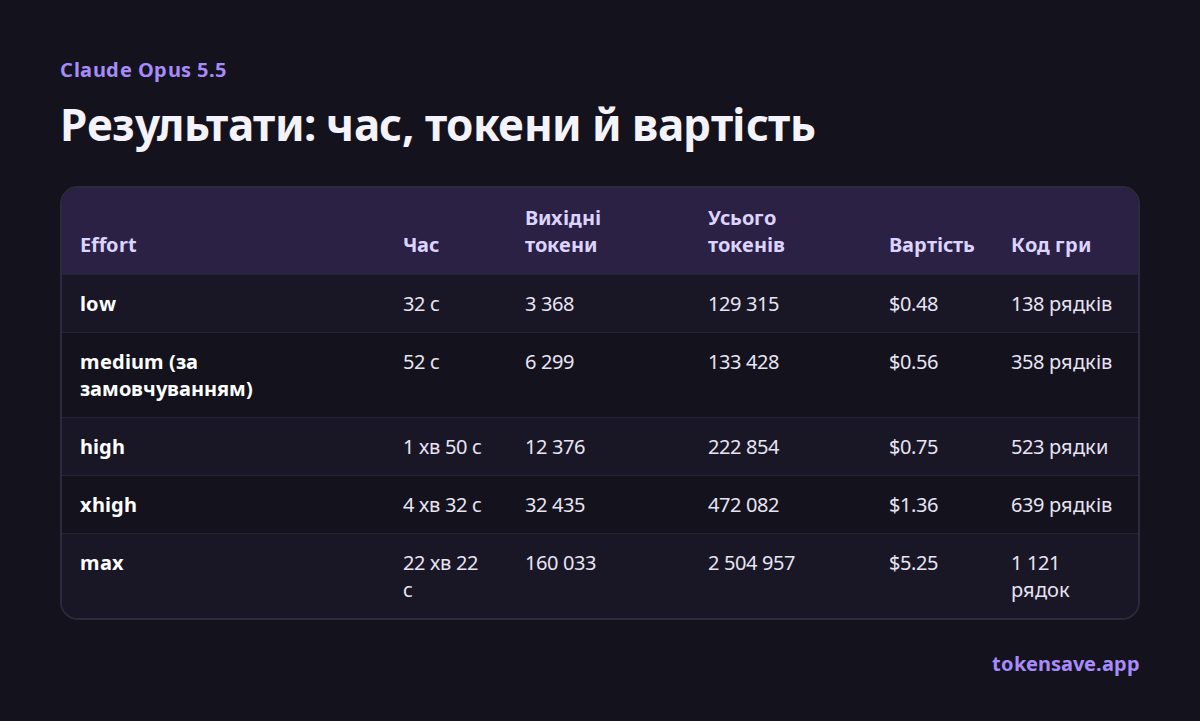
| Effort | Час | Вихідні токени | Усього токенів | Вартість | Код гри |
|---|---|---|---|---|---|
| low | 32 с | 3 368 | 129 315 | $0.48 | 138 рядків |
| medium (за замовчуванням) | 52 с | 6 299 | 133 428 | $0.56 | 358 рядків |
| high | 1 хв 50 с | 12 376 | 222 854 | $0.75 | 523 рядки |
| xhigh | 4 хв 32 с | 32 435 | 472 082 | $1.36 | 639 рядків |
| max | 22 хв 22 с | 160 033 | 2 504 957 | $5.25 | 1 121 рядок |
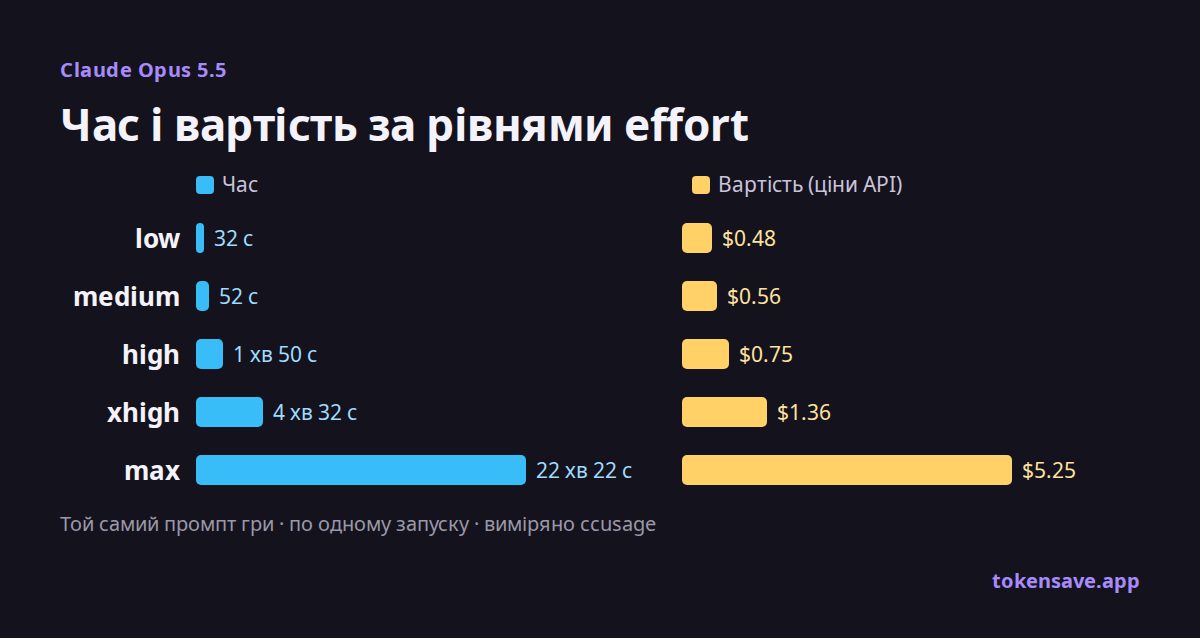
- Low і medium майже однакові. Low коштував на 14% менше й зайняв на 38% менше часу, але це лише 8 центів.
- High коштував лише на 34% більше за medium. Час зріс із 52 секунд до 1 хвилини 50 секунд.
- На xhigh витрати різко зростають. Він коштував на 143% більше за medium і зайняв 4 хвилини 32 секунди.
- Max — окрема ліга. Medium: 52 секунди й $0.56; max: 22 хвилини 22 секунди й $5.25. Вихідних токенів стало 160 033 замість 6 299.
П’ять ігор поруч
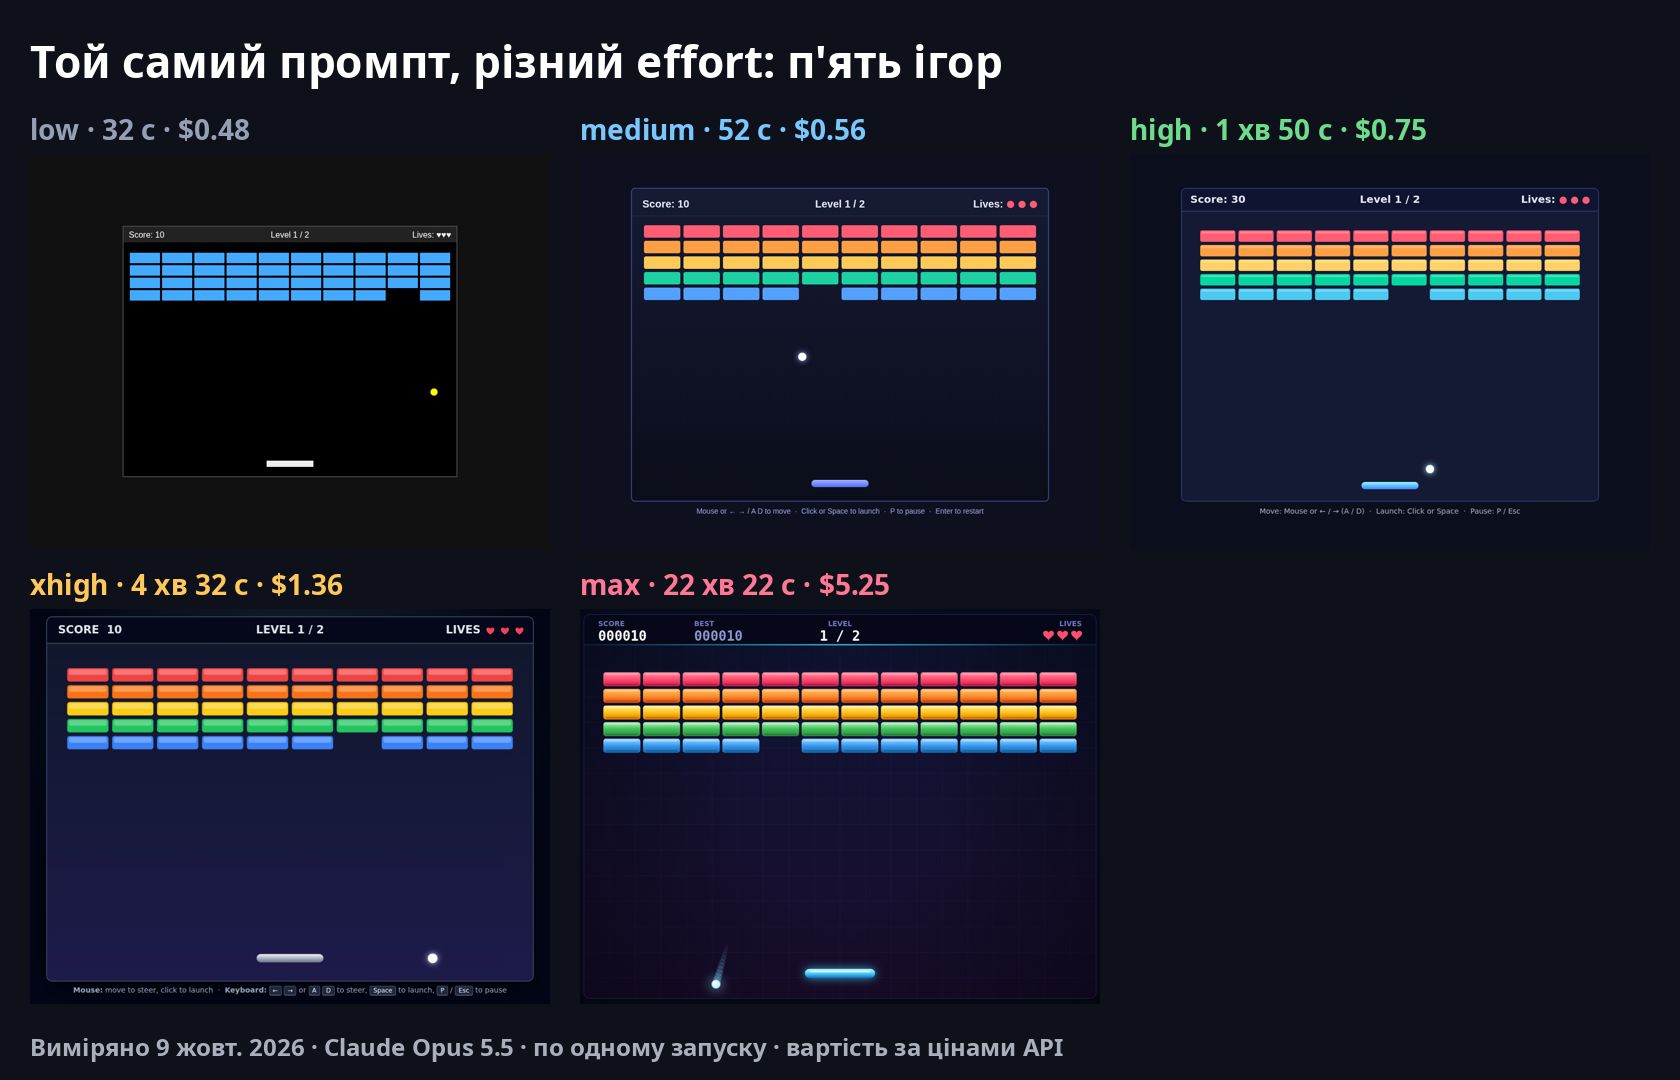
Усі п’ять ігор запустилися без помилок і виконали запит: 2 рівні, рахунок, 3 життя, керування з клавіатури й миші. Відмінності — у тому, що кожен рівень додав понад це.
| Effort | Що додано |
|---|---|
| low | Одноколірні цеглинки, найпростіший екран, без паузи |
| medium | Райдужні цеглинки, пауза, перезапуск |
| high | + ефекти частинок, збереження найкращого рахунку |
| xhigh | Ефекти частинок, охайніший дизайн (без збереження найкращого рахунку) |
| max | + звукові ефекти, назви рівнів, рівень 2 у формі прибульця, тремтіння екрана, переможний феєрверк |
- Починаючи з high, модель намагалася перевірити власну роботу. High і xhigh пробували перевірити синтаксис коду, а max — запустити автоматичний ігровий тест. Усі три потребували дозволу на запуск, тож жодна перевірка так і не виконалася; натомість кожен пише, що перечитав код. Low і medium завершили роботу без перевірки.
- Цеглинки, які розбиваються з двох ударів, з’явилися на всіх рівнях, хоча ми про них не просили.
Огляд за рівнями
Ми зіграли в кожну гру й звірили її з підсумком, який модель залишила наприкінці, та із самим кодом.
low: 32 с, $0.48
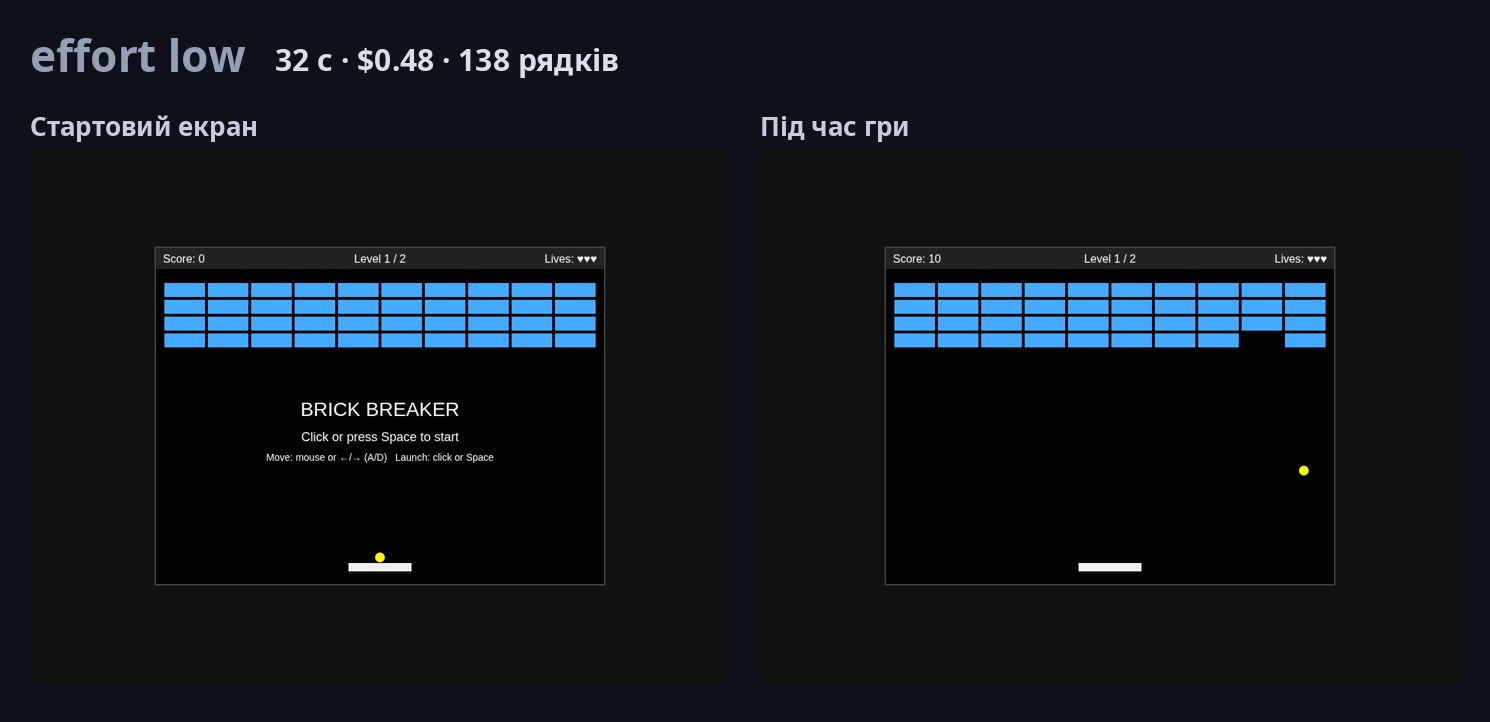
- Що зроблено: рівень 1 — чотири ряди синіх цеглинок; на рівні 2 помаранчеві цеглинки, які розбиваються з двох ударів, чергуються з проміжками, а м’яч рухається швидше. Є екрани проходження рівня, програшу й перемоги та перезапуск.
- Добре: усі запитані функції на місці, а кут відскоку залежить від того, куди м’яч влучив у платформу. Готово за 32 секунди.
- Слабко: чорне тло й одноколірні цеглинки роблять гру найпростішою на вигляд. Немає паузи, а 138 рядків — найкоротший код.
- Коли використовувати: коли треба лише перевірити, що щось працює, а шліфувати будете пізніше.
medium: 52 с, $0.56 (за замовчуванням)
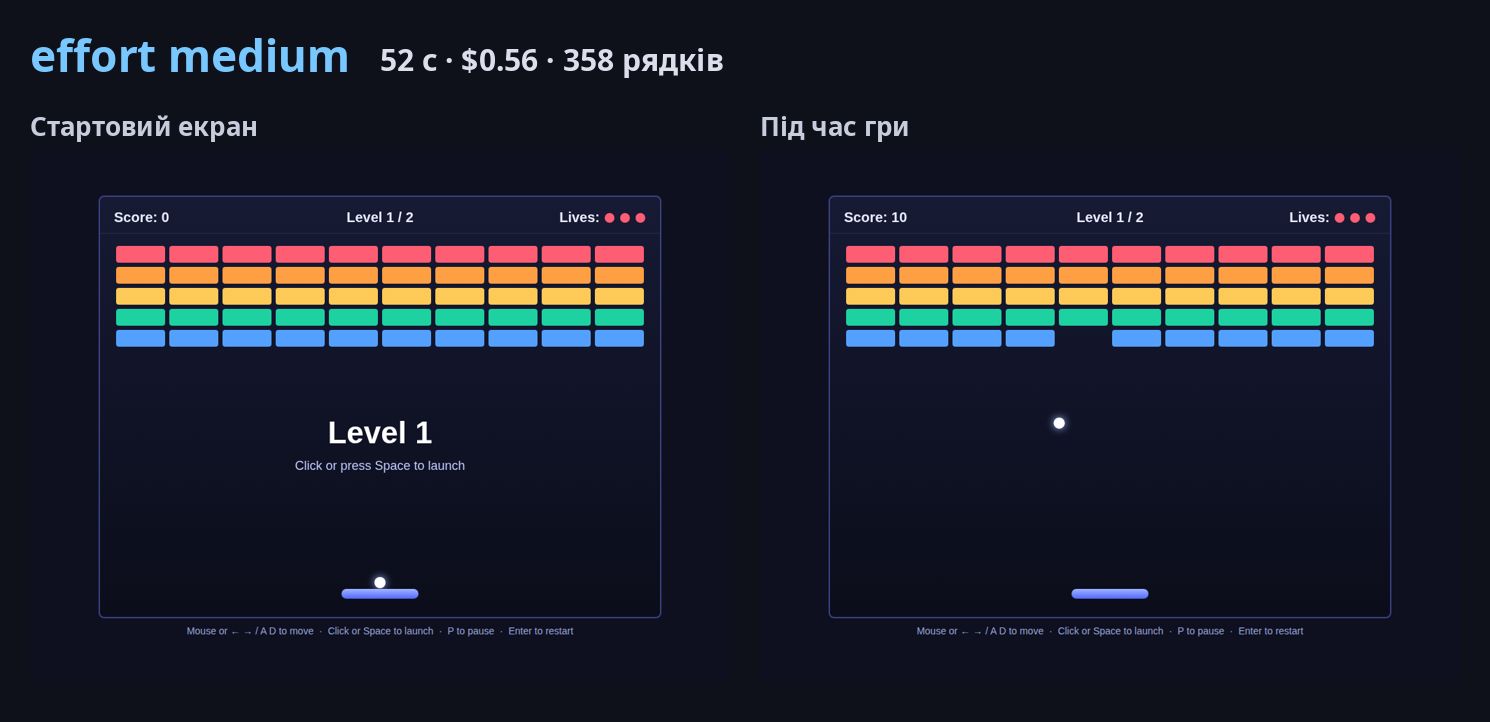
- Що зроблено: рівень 1 — райдужна сітка 5×10; на рівні 2 є проміжки й цеглинки, які розбиваються з 2 або 3 ударів, показують, скільки ударів лишилося, і тьмяніють від пошкоджень.
- Добре: пауза (P або Esc), перезапуск (Enter) і автопауза, коли вікно втрачає фокус. Очки залежать від міцності цеглинки та рівня.
- Слабко: немає звуків і ефектів частинок.
- Коли використовувати: здебільшого. Коштує на 8 центів більше за low і помітно кращий.
high: 1 хв 50 с, $0.75
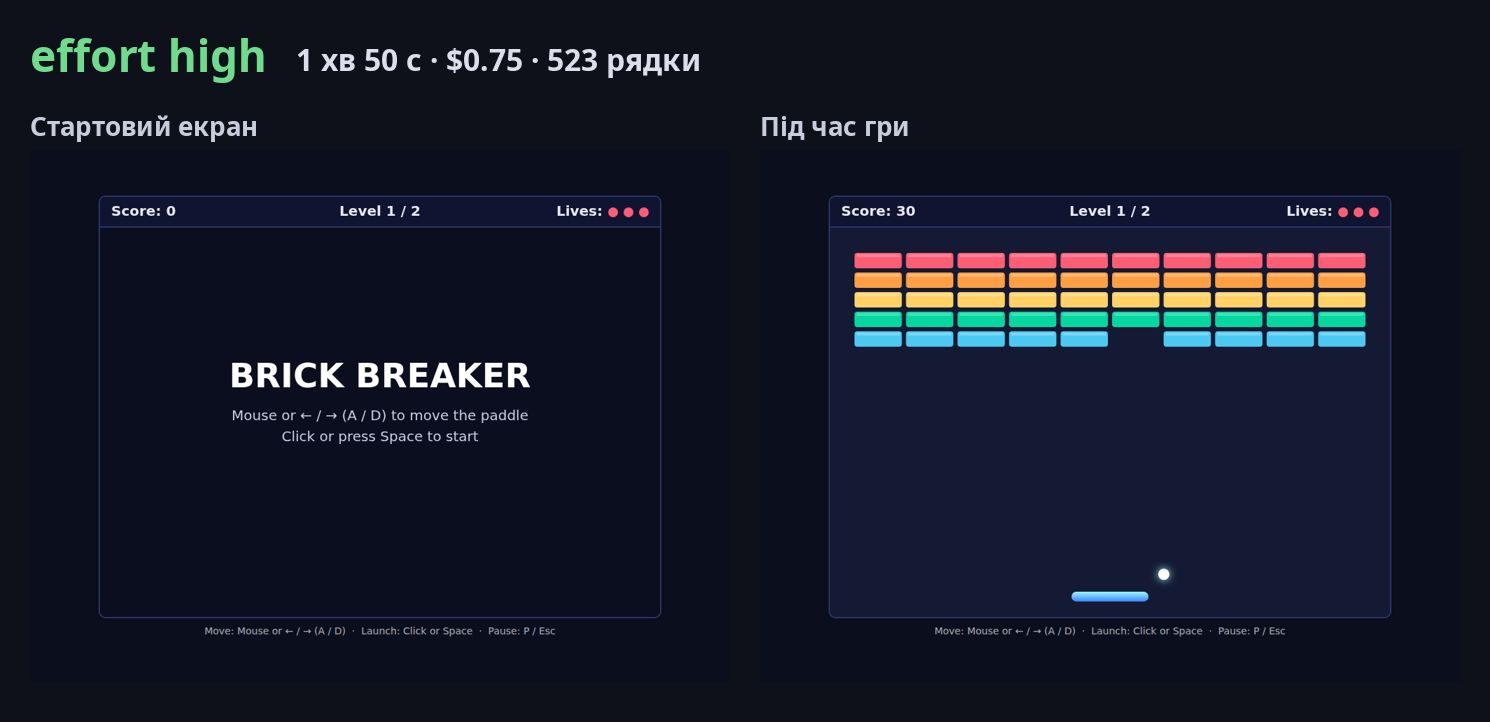
- Що зроблено: рівень 2 — ромб із цеглинок, які розбиваються з 2 або 3 ударів, а при руйнуванні цеглинки розлітаються частинками.
- Добре: бонус за проходження рівня, бонус за збережені життя, збереження найкращого рахунку та сенсорне керування. Також модель сама спробувала перевірити синтаксис свого коду.
- Слабко: робота тривала на 112% довше, ніж на medium (52 секунди проти 1 хвилини 50 секунд).
- Коли використовувати: для прототипу, який треба комусь показати, або для програмування, де важлива якість. Коштував лише на 34% більше за medium.
xhigh: 4 хв 32 с, $1.36
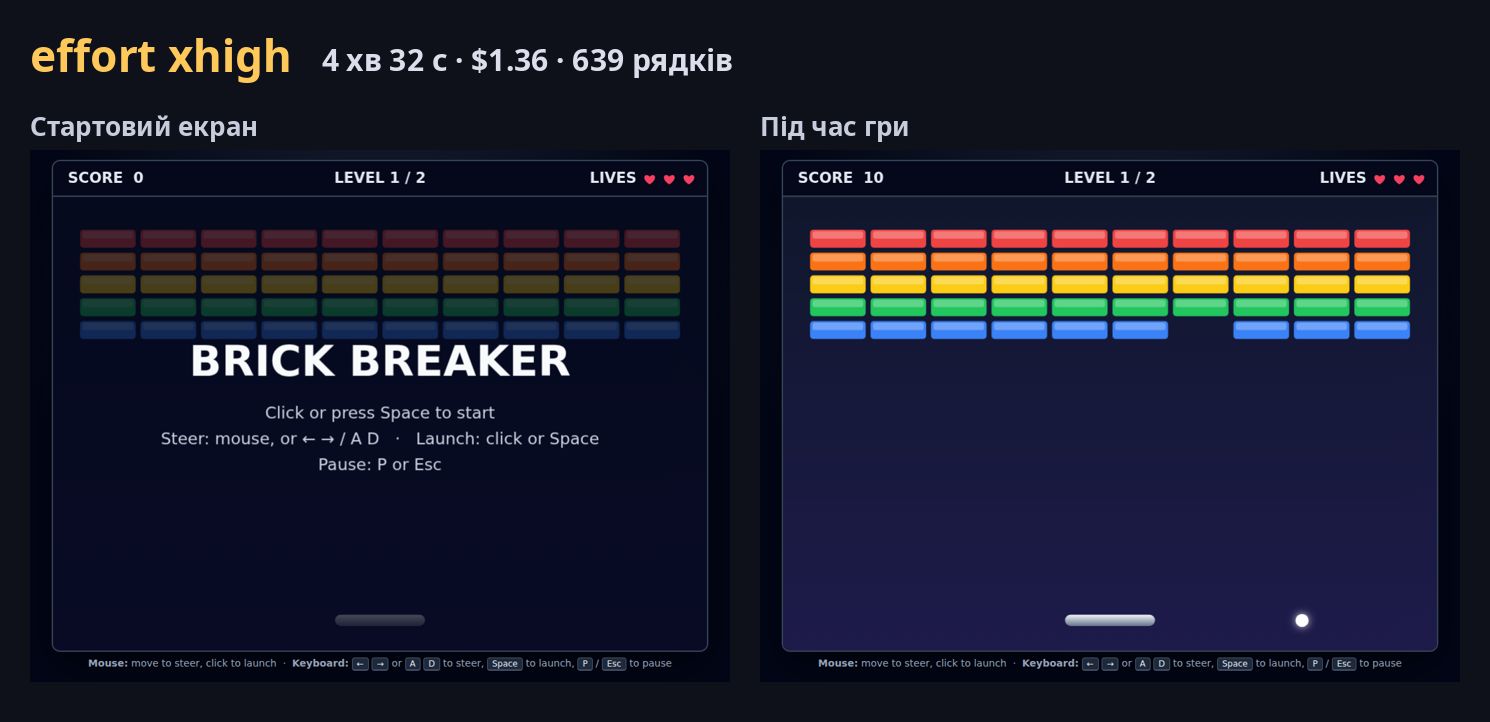
- Що зроблено: рівень 2 — ромб в оточенні сталевих цеглинок, які тріскаються після першого удару. Цеглинки дають від 10 до 50 очок залежно від кольору.
- Добре: найохайніший екран, а поєднання миші й клавіатури працює плавно: платформою керує той пристрій, яким ви скористалися останнім.
- Слабко: зникли збереження найкращого рахунку та сенсорне керування, які були в high. Коштував на 143% більше за medium, не додавши функцій порівняно з high.
- Коли використовувати: не для таких невеликих завдань. За словами Anthropic, він підходить для тривалої роботи.
max: 22 хв 22 с, $5.25
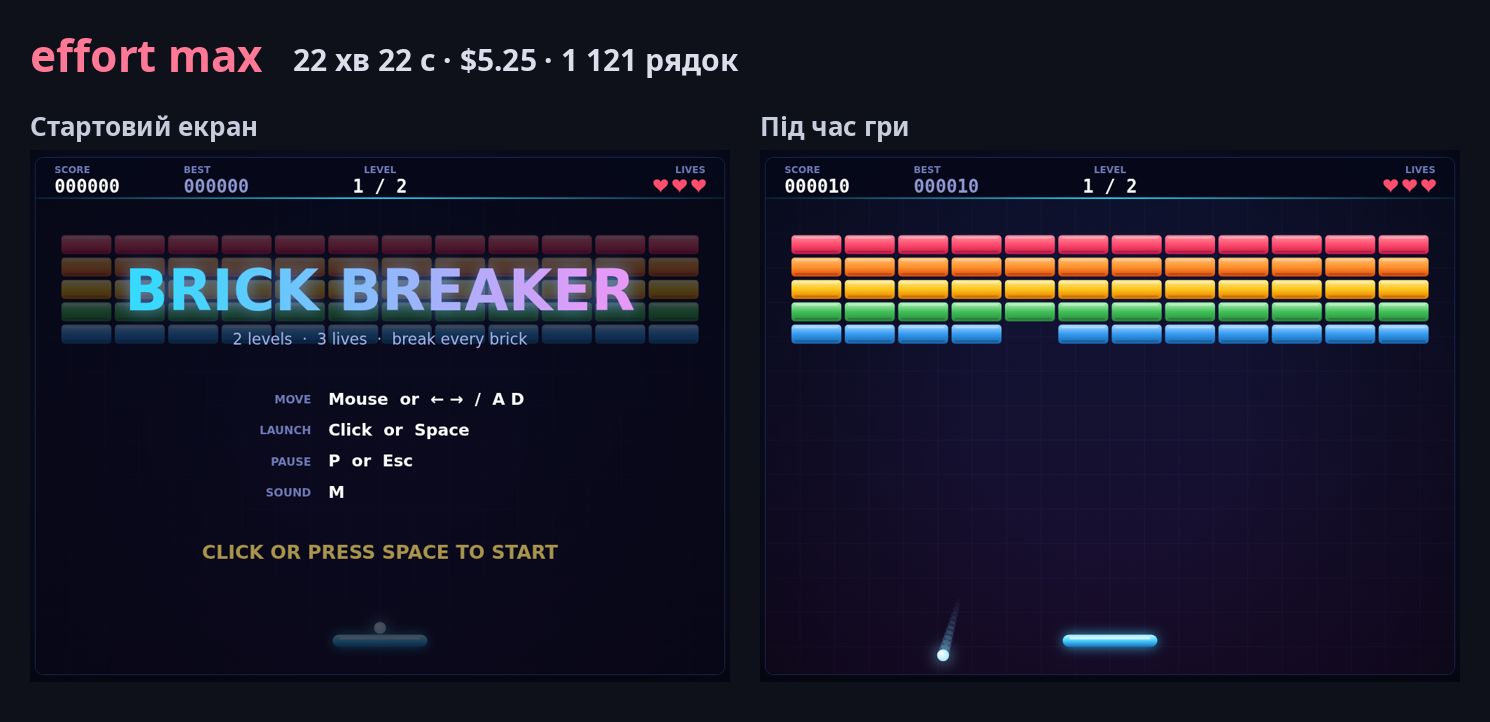
- Що зроблено: рівні з назвами («Rainbow Wall», «Space Invader»), рівень 2 у формі прибульця, де 14 срібних цеглинок розбиваються з двох ударів, і вужча платформа на рівні 2.
- Добре: звукові ефекти (M — увімкнути/вимкнути), збереження найкращого рахунку, сенсорне керування, тремтіння екрана, переможний феєрверк і автопауза — найбільше з усіх рівнів. Виглядає як готова гра.
- Слабко: найповільніший з великим відривом, частково тому, що намагався запустити автоматичний ігровий тест, для якого потрібен був дозвіл.
- Коли використовувати: коли якість понад усе і є запас часу та лімітів, або коли ніщо інше не розв’язує проблему.
Особистий досвід: medium щодня, high для коду
Я роблю ігри з Opus 5.5 на плані Claude Max 5x. Це відчуття від щоденного використання, а не вимірювання.
- Моє налаштування: я залишаю effort на auto. Зазвичай він працює на medium і піднімається до high, коли я пишу код.
- low: він здавався млявим, тож я трохи ним покористувався й покинув.
- high: результати помітно кращі.
- xhigh і max: я спробував їх хіба що по одному запуску й рідко маю причину ними користуватися.
Якщо порівняти з вимірюваннями, low насправді був найшвидшим, але дав найпростіший результат, тож відчуття млявості стосувалося результату, а не швидкості. Враження, що high дає кращі результати, а xhigh і max потрібні рідко, збіглося з цифрами.
Що рекомендує Anthropic
- Medium — сильний рівень. У тестах Anthropic Opus 5.5 на medium зрівнявся з Opus 5 на high або перевершив його в програмуванні та роботі зі знаннями.
- Low на програмуванні наближається до medium за значно нижчої вартості, за словами Anthropic. У нашому тесті різниця в результаті була помітною.
- Залишайте xhigh і max для завдань, де ви виміряли приріст якості.
- Зміна effort посеред розмови може зламати кеш промптів. В API змінюйте effort для окремого повідомлення, щоб зберегти кеш.
- Незалежні тести це підтверджують. Artificial Analysis з’ясувала, що Opus 5.5 на effort max використовував на 63% більше вихідних токенів на завдання, ніж Opus 5 (за повідомленнями преси).
Який effort для якого завдання
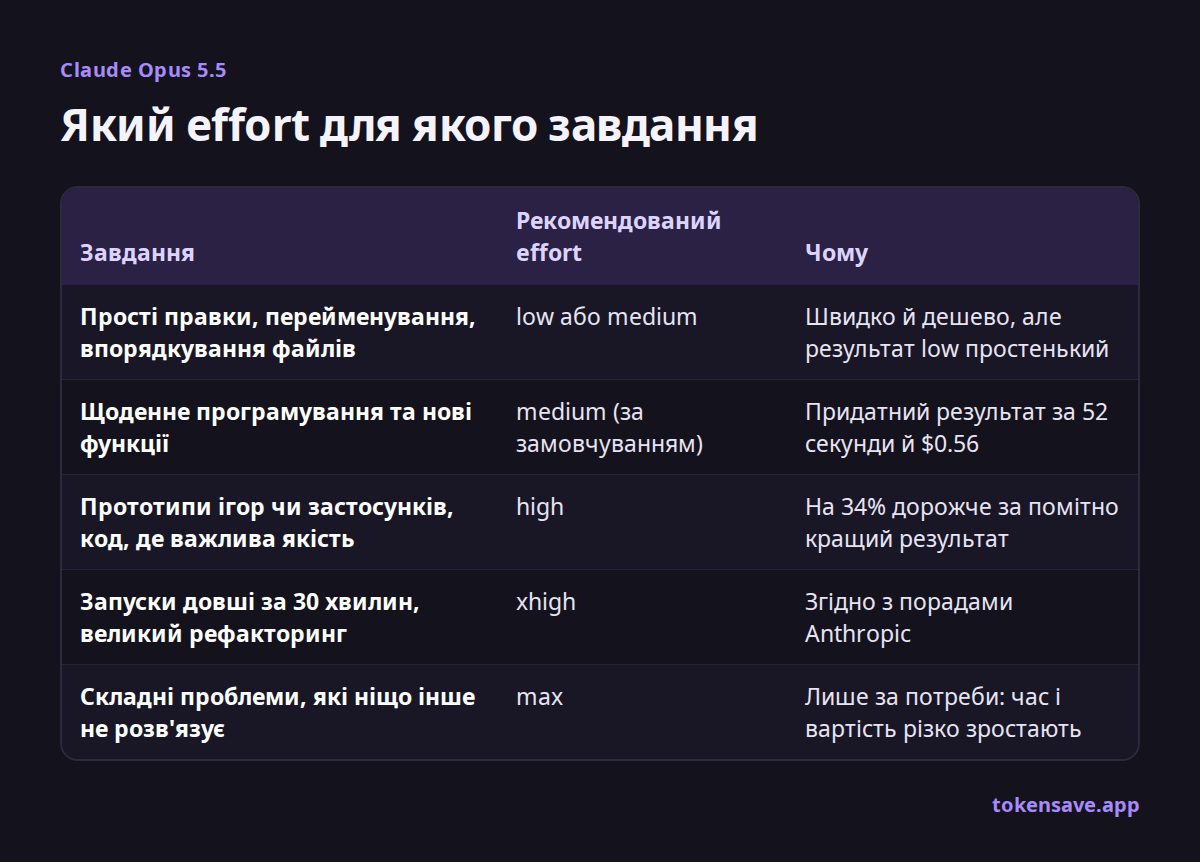
Наші рекомендації з урахуванням вимірювань, мого досвіду та порад Anthropic:
| Завдання | Рекомендований effort | Чому |
|---|---|---|
| Прості правки, перейменування, впорядкування файлів | low або medium | Швидко й дешево, але результат low простенький |
| Щоденне програмування та нові функції | medium (за замовчуванням) | Придатний результат за 52 секунди й $0.56 |
| Прототипи ігор чи застосунків, код, де важлива якість | high | На 34% дорожче за помітно кращий результат |
| Запуски довші за 30 хвилин, великий рефакторинг | xhigh | Згідно з порадами Anthropic |
| Складні проблеми, які ніщо інше не розв’язує | max | Лише за потреби: час і вартість різко зростають |
- Починайте з medium. Переводьте на high лише ті завдання, де результату бракує.
- На підписці думайте в лімітах. Що вища вартість в еквіваленті API, то швидше вичерпується ліміт Max чи Pro. Один запуск max витратив більше, ніж дев’ять запусків medium.
- Застереження: по одному запуску на рівень на досить невеликому завданні. На більших проєктах різниця може бути іншою.
Висновок: medium за замовчуванням, high, коли важлива якість
- За замовчуванням: medium. Придатний результат за 52 секунди й $0.56.
- Коли важлива якість: high. Лише на 34% дорожче за medium за помітно кращий результат. Найвигідніший із п’яти.
- xhigh: пропускайте для невеликих завдань. На 143% дорожче за medium, але функцій не більше, ніж у high. Виправданий лише для тривалих запусків.
- max: лише коли справді потрібно. Найефектніший результат, але 22 хвилини й $5.25.
- low: не рекомендуємо. Економія 8 центів порівняно з medium дає лише простіший результат.
Часті запитання
Який effort за замовчуванням в Opus 5.5? Medium. В Opus 5 за замовчуванням був high. Запити до API, у яких effort не задано, на Opus 5.5 виконуються на medium.
Чи max завжди кращий? У нашому тесті він додав найбільше функцій і шліфування, але зайняв 22 хвилини й $5.25 проти 52 секунд і $0.56 на medium. Забагато для простої роботи.
Чи багато заощаджує low? У нашому тесті low був лише на 14% дешевшим за medium. З огляду на простіший результат, medium — кращий вибір.
Порахуйте для власної роботи
У калькуляторі вартості агентів для програмування введіть розмір завдання й кількість завдань на день, щоб побачити місяць на Opus 5.5. Вартість окремого промпту перевірте в лічильнику токенів. Про різницю в ціні та продуктивності між Opus 5 і 5.5 читайте в статті Claude Opus 5 vs 5.5 (англійською).
Виміряно 9 жовтня 2026 року. Вартість — перерахунок ccusage за цінами API; результати можуть змінитися з оновленнями моделі та Claude Code.
Джерела
- Anthropic: Effort
- Anthropic: Промптинг для Claude Opus 5.5
- Anthropic: Перехід із Claude Opus 5 на Opus 5.5
- OfficeChai: звіт Artificial Analysis Intelligence Index
- ccusage: інструмент обліку використання Claude Code (GitHub)
Оригінал статті: tokensave.app.
11 коментарів
Додати коментар Підписатись на коментаріВідписатись від коментарів성함이 조재현이세요?
Додатиб до аналізу різні варіанти сонет, і фейбл, булоб круто )
Дякую! Sonnet 5.5 на тому самому завданні вже порівнював: tokensave.app/...de-sonnet-5-5-vs-opus-5-5 . Fable поки не тестував — гарна ідея для наступного разу.
довольно странное сравнение в том смысле, что модель начинает что-то додумывать в области фич, которые просто выпадают за область промпта. типа в исходном задании не было ничего про звук, значит звук можно не делать. или делать, потому что где вы видели игру без звука?
как по мне, на практике это все малополезно, потому что вещи типа визуального стиля игры все равно должен определять человек, а не додумывать машина, в зависимости от того, какой уровень ей выставили.
более интересно было бы видеть истории, когда уровень модели определяет результат бинарно — или модель справилась, или нет. например — нашла и починила баг или не смогла.
или когда человек лезет в код и оценивает результаты. у меня был кейс, когда с рефакторингом на удовлетворительном уровне не мог справиться ни Sol, ни Opus, а вот Fable — смогла.
Слушне зауваження. Завдання справді було відкрите, тому вищі рівні частково «додумували» фічі. Бінарний тест на кшталт «знайшов і виправив баг чи ні» дав би чистіший результат — дякую за ідею. І цікавий кейс із рефакторингом, з яким впоралася лише Fable.
А чому пишете на DOU? Вам цікава наша спільнота, українська аудиторія, або можливо, працюєте в Україні? Цікаво 🙃
Дякую за запитання! Пишу з Кореї. DOU — одне з небагатьох місць, де технічні тексти справді читають і обговорюють, тож хотілося поділитися результатами з українськими розробниками. Тексти перекладаю українською.
Північної чи Південної?:)
Крутий аналіз, завжди юзаю high
Південної, звісно 😄 Дякую! Я зазвичай на medium, а коли пишу код — high.
Ви б хоч ті ігри показали що ви зробили, бо уся стаття про те як налаштовувати нейроночки та їх продуктивність, а що саме ви з ними зробили та який результат — не зрозуміло. Тобто знову нейроночки заради нейроночок.
Слушне зауваження, дякую! Ігри є, обидві в Google Play — я не написав жодного рядка коду сам, усе робив з AI:
— Sperm Race — аркадні гонки: play.google.com/...ils?id=com.spermrace.game
— Gold & Noble (корейською 금의 제왕) — економічна стратегія про золоту лихоманку 1849 року: play.google.com/...id=com.jaehyun.kingofgold
Надалі планую публікувати тут і щоденник розробки цих ігор.